~第2回 ENSAPIA Engineering #Japan AI ハッカソン~
-
2026年8月27日

「ハーネスソン(ハーネス×ハッカソン)」開催レポート──第2回 ENSAPIA Engineering #Japan AI ハッカソン
こんにちは。AI EvangelistのNakjiです。
ENSAPIA Engineeringは、AIをツールとして活用するだけでなく、戦略・開発・組織文化そのものをAIで再構築していく「AI Centric」な組織づくりを推進しています。
日々進化するAIと共創する新しいエンジニアリングのあり方を模索する中で、実践を通じて知見を蓄積し、組織全体へ展開する取り組みを続けています。
その取り組みの一つが、定期的に社内で開催しているAI ハッカソンです。
2026年7月16日から21日にかけて、東京と福岡のエンジニアが参加する第2回 #Japan AI ハッカソンを、オンライン・オフラインのハイブリッド形式で開催しました。今回は「ハーネス」と「ハッカソン」を組み合わせた、AIハーネス開発に挑戦する「ハーネスソン(Harness-thon)」を開催しました。
第1回がAIを活用して現場の不便を解決することに焦点を当てていたのに対し、今回は一歩進み、AIが安定して働くための開発構造そのものを作ることに挑戦しました。
今回のミッションは一つです。
「一度の実行で、仕様書を動作する成果物に変えるAIハーネスを構築せよ。」
参加者が作る中心的な成果物はアプリではありません。仕様書を入力としてAIコーディングエージェントをオーケストレーションし、実装・検証・修正までを自動で行うAIハーネス(harness)です。
この記事の要点(TL;DR)
- AIハーネスは、複数のAIエージェントに役割とルールを与え、仕様書から実装・検証・修正までを自動化する仕組みです。
- 第2回 #Japan AI ハッカソンでは、8チーム・9名が一度の実行で動作する成果物を生み出す、再現可能なハーネス開発に挑戦しました。
- 品質を支えるのはモデル性能だけでなく、テスト・レビュー・失敗時の修復を組み込んだ検証ループです。
AIハーネスとは?
AIハーネスとは、Claude Code、GitHub Copilot、CodexなどのAIエージェントが、定められた役割とルールに従って協働するための実行システムです。
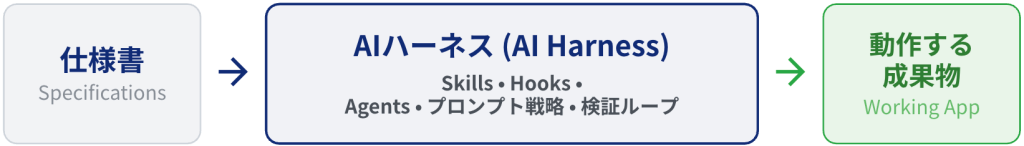
LLMに長いプロンプトを渡してコードを生成するだけの方法とは異なります。要件分析、設計、実装、テスト、レビュー、エラー修正といった開発工程を構造化し、各工程の完了条件や失敗時の対応まで定義します。
AI開発の関心も、プロンプトエンジニアリング → ハーネスエンジニアリング → ループエンジニアリングへと広がっています。一度の指示を工夫する段階から、エージェント・ツール・権限を構造化し、結果を検証しながら目標達成まで反復・修復するループを設計する段階への変化です。今回のハーネスソンは、この流れを実際に試す場でもありました。
そのため、完成したアプリだけを評価したわけではありません。次の問いに答えられることを重視しました。
- 一つのコマンドで再現可能な形で実行できるか
- AIのミスや誤った「完了」判断をどう検証するか
- 失敗時に自動修正、または安全な停止ができるか
- 別の仕様書や実務にも再利用できるか
開会式 — AIを使う人から、AIが働く仕組みを作る人へ
7月16日の開会式では、開催目的、進行方法、提出物、審査基準を共有しました。
参加者にはコーデ共有アプリ「Closet」のベース仕様書を提供しました。ただし、仕様の解釈や補足、実装範囲、言語・フレームワーク、AIツールの構成は自由としました。
審査員とAIが、次の4つの観点を中心に評価しました。
- ハーネス完成度 — 実行環境の完成度と使いやすさ
- 技術的完成度 — 実装レベルと多様な技術の活用
- 業務活用度 — 実務への適用・拡張可能性
- 仕様完成度 — ベース仕様書の要件を満たした度合い
AI採点には、今回の審査に向けて私が独自に作成したハーネス評価レポート作成スキル「harness-evaluator」を使用しました。各チームの仕様書、AIハーネス、生成物を読み、上記4基準で分析する仕組みです。
AIが成果物を見て主観的に点数を付けるだけではありません。エージェント構成、検証・修復ループ、テストコード、実行ログ、スクリーンショットなどを確認し、評価根拠となるコード位置と実行証拠を記録します。分析結果は、総合点、ハーネス種別、機能要約、段階別の実行シミュレーションと根拠を含む構造化JSONとして出力され、そこから人が読みやすいチーム別評価レポートを自動作成します。異なる技術や実装方法の提出物を同じ基準で比較しながら、なぜその点数になったのかを審査員が再確認できる透明性の高いAI審査を実現しました。最終結果は、AI評価レポートと審査員の確認を総合して決定しました。
"harness": "octo-closet-harness",
"source": "...",
"repo_type": "plugin",
"total_score": 34.739583333333336,
"llm_analysis": {
  "summary": "octo-harness は Claude Code 用のサンプルハーネスで、仕様書 md を入力すると /octo-build スキルがパイプラインを駆動する。作業を8パートに分解し、leg サブエージェント8体を並列実行した後、inspector エージェントが採点し、基準未満なら担当 leg が再作業する。",
  "simulation": [
    "settings.json のフック配線をロードする (settings.json:2-23)",
    "/octo-build <仕様書.md> でスキルを起動する (skills/octo-build/SKILL.md:10)",
    "仕様書を読み、作業を8パートに分解する (skills/octo-build/SKILL.md:14-19)",
    "leg エージェント8体を同時に実行する (skills/octo-build/SKILL.md:21-24)",
    "各 leg が完了結果をオーケストレーターへ報告する (agents/leg.md:4-18)",
    ...
  ]
}
本イベント — 8チームが生み出した8つの答え
7月17日の本イベントには8チーム・9名が参加し、1日でそれぞれのハーネスを設計・実行して、成果物と検証証拠を作りました。
同じ仕様書から始めても、アプローチは多様でした。
- 複数のAIエージェントを役割別に分けて並列実行
- テストを先に固定し、実装を反復するTDD構成
- 生成側と評価側を分離し、自己評価の限界を抑える構成
- MCPとPlaywrightをつなぎ、実データと画面を検証
- 実行状態を保存し、失敗地点から再開
- Unityのコンパイル、PlayModeテスト、スクリーンショット、ビルドを自動検証
- 画像からUI情報を抽出し、C++アプリケーションを生成
- 発見した失敗をルールとゲートへ反映し、ハーネス自体を改善
会場では、AIの実装中に次の戦略を調整し、想定外のエラーを検証ルールへ変え、限られた時間で自動化範囲を見極める姿が見られました。AIが速くコードを書くことと同じくらい、どこまで任せ、何をどの基準で検証するかを設計する力が重要だと確認できました。
仕様書から成果物、実行証拠まで
夕方の発表会では、各チームがデモ画面だけでなく、次の資料も公開しました。
- 入力した仕様書と解釈・変更内容
- Skills、Agents、Hooks、プロンプトなどで構成したハーネス
- ハーネスが実際に生成したアプリケーション
- テスト結果、実行ログ、スクリーンショットなど、一度の実行を示す証拠
発表の中心は「どんなアプリを作ったか」だけではありません。なぜこのエージェント構成を選んだのか、AIの誤動作をどう防いだのか、失敗をどう修復したのか、実務でどう再利用できるのかが語られました。
「ヌンチ」は、仕様書一つからUnityプロジェクト、macOSビルド、要件トレーサビリティ付きの検証資料までを生成する9段階のパイプラインを実装。「チョコ探求倶楽部」は、企画書とレイアウト画像から社内C++ライブラリベースのアプリを生成する7エージェント構成を披露しました。「あさい」は、生成と評価を分離した多層検証ゲートにより、モデルを変更しても品質を維持しつつ、実行時間とコストを削減した結果を示しました。
結果発表 — 完成度と再現性を証明したチーム
7月21日の結果発表会では、審査員とAIによる総合評価をもとに受賞チームを発表しました。
🥇 優勝 — チーム:初夢縁起物
「初夢縁起物」チームは、仕様書入力から要件抽出、設計、実装、テスト、修正、受け入れ準備までをつなぐ18段階のWebサービス実装ハーネスを構築しました。
要件・受け入れ条件・実装タスク・テストにIDを付与し、全工程を追跡。状態保存と再開、破壊的変更の防止、二重AIレビュー、修正結果の再発防止ルールへの反映まで実装しました。実行時には必須要件15件と自動テスト15件をすべて通過した具体的な証拠を提示し、実務適用性と安定性の両面で高く評価されました。

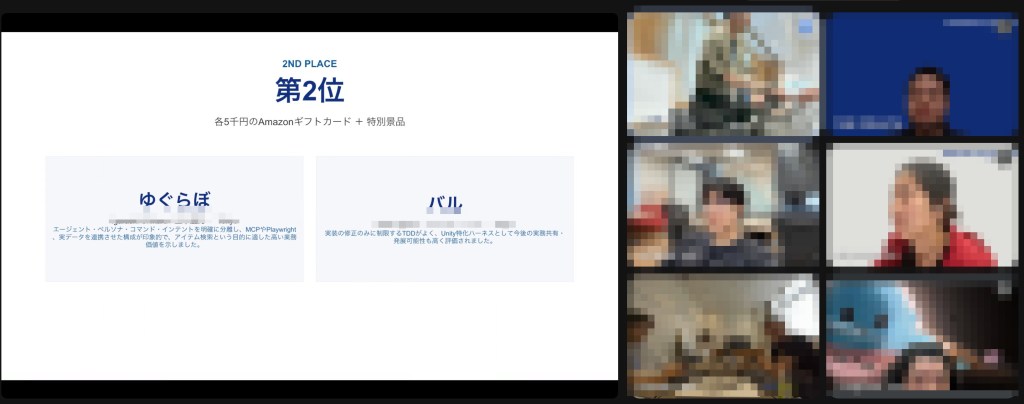
🥈 第2位 — チーム:ゆぐらぼ / バル
- ゆぐらぼ — エージェント・ペルソナ・コマンド・インテントを明確に分離し、MCP、Playwright、実データを連携。アイテム検索という目的に合った高い業務価値を示しました。
- バル — 仕様の不変条件からテストを先に定義し、実装修正に集中するTDD構成を採用。Unity特化ハーネスとしての実務共有・発展可能性が評価されました。
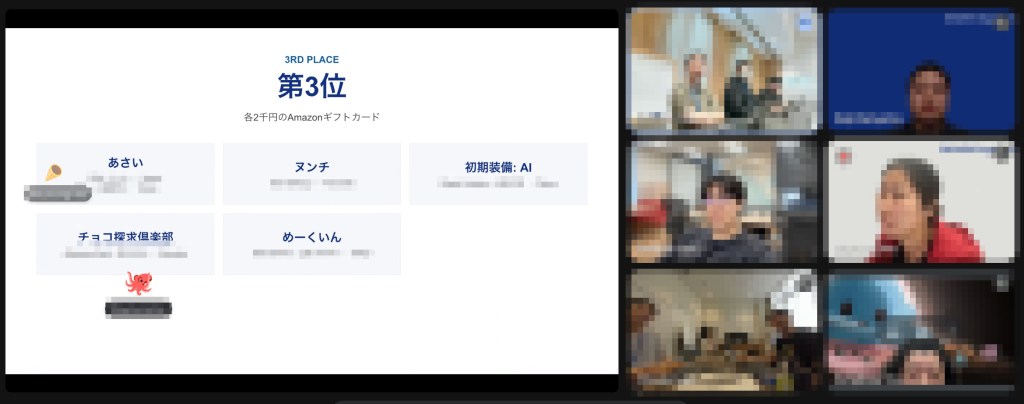
🥉 第3位 — チーム:あさい / ヌンチ / 初期装備: AI / チョコ探求倶楽部 / めーくいん
各チームは、生成と評価の分離、Unity検証ゲート、マルチエージェント並列化、画像ベースのUIコード生成など、異なる強みを披露しました。すべてのチームが限られた時間で独自ハーネスを実行し、試行錯誤と今後の改善方針まで共有したことにも大きな意義がありました。
開催を通じて分かったこと
- 品質はモデル性能だけでは保証できません。 テスト、レビュー、完了条件、停止条件などの検証構造が必要です。
- 失敗はハーネスを改善するデータになります。 一度見つけたエラーを個別修正で終わらせず、ルールと自動検証ゲートへ変換すれば再発を減らせます。
- AI活用の中心は、プロンプトからシステム設計へ移っています。 モデルの選択だけでなく、役割、権限、状態、コスト、検証、修復をどう設計するかが再現性を決めます。
おわりに
第1回ではAIを使って現場の不便を解決する多様なアイデアを確認しました。第2回ではその経験をもとに、AIがより複雑な開発作業を安定して行うための再現可能なプロセスに挑戦しました。
1日で生まれた8つのハーネスは、技術やアプローチは異なっていても、一つの方向を示していました。
AIを「使う」から、AIが安定して成果を生み出す「仕組みを作る」へ。
今回得られた経験とノウハウが各チームの実際の開発プロセスにつながり、ENSAPIA EngineeringのAI活用文化をさらに広げる出発点になることを期待しています。
最後までお読みいただき、ありがとうございました。